On dit ce qu'on fait, on fait ce qu'on dit
et pourquoi ça marche !
L’intelligence artificielle n’est pas magique : c’est des mathématiques et beaucoup d’ingénierie.
La différence entre un projet qui aboutit et un projet qui s’enlise se joue rarement sur le choix de l’outil, et presque toujours sur trois questions : le problème est-il bien posé, les données existent-elles vraiment, et sait-on reconnaître que ça marche ? Nous commençons par là, et nous travaillons au niveau du modèle, pas seulement en assemblant des briques existantes.
Nous accompagnons les entreprises qui ont un sujet sérieux et qui cherchent un interlocuteur capable d’en parler sans jargon quand il le faut, et dans le détail quand c’est utile. Nous disons aussi non quand un sujet ne se traite pas sérieusement.
Quatre axes techniques. Une seule exigence : la rigueur.
Du signal brut au modèle en production : nous couvrons l'intégralité de la chaîne.
Vision par ordinateur
Reconnaître et situer ce qui apparaît sur une image ou dans un flux vidéo : une pièce défectueuse sur une ligne, une plaque, une zone d’un plan. Nous utilisons des réseaux de neurones convolutifs adaptés à vos images, et non des modèles génériques.
Lecture de documents
Transformer un document scanné en données exploitables : factures, bons de livraison, formulaires administratifs. La reconnaissance de caractères seule ne suffit pas : l’essentiel du travail consiste à nettoyer l’image avant, et à vérifier le résultat après, avec les règles de votre métier.
Parole et langage
Faire saisir par la voix là où les mains sont occupées : un cariste, un technicien en intervention, un chauffeur. La reconnaissance vocale tourne sur l’appareil lui-même, sans passer par un service externe, donc sans que vos échanges quittent vos murs.
Modèles prédictifs
Anticiper à partir de ce qui s’est déjà produit : une panne qui s’annonce, un client qui s’éloigne, une anomalie dans des écritures. Nous comparons plusieurs approches sur vos données plutôt que d’imposer la nôtre, et nous expliquons chaque prédiction : une prévision qu’on ne peut pas justifier ne sert à personne.
OCR sur documents administratifs et factures
Des problèmes réels. Des solutions qui tournent.
1. Nettoyer l’image
Le document arrive souvent de travers, froissé ou photographié de nuit : il est d’abord redressé et nettoyé.
2. Repérer les zones utiles
Nous repérons ensuite ce qui est quoi : le texte courant, les tableaux, les cases à lire.
3. Lire le texte
La lecture proprement dite, affinée sur vos documents plutôt que sur un corpus générique.
4. Corriger les erreurs de lecture
Les erreurs de lecture sont corrigées avec le vocabulaire de votre métier, qui connaît vos références et vos fournisseurs.
5. Contrôler et structurer
Enfin chaque valeur est confrontée aux règles de votre métier, et ce qui reste douteux est signalé pour relecture plutôt que livré comme certain.
Nous mesurons la qualité sur vos documents, pas sur un jeu d’essai public, et nous vous montrons les erreurs avant de parler de résultats.
Détection d'objets et classification par CNN
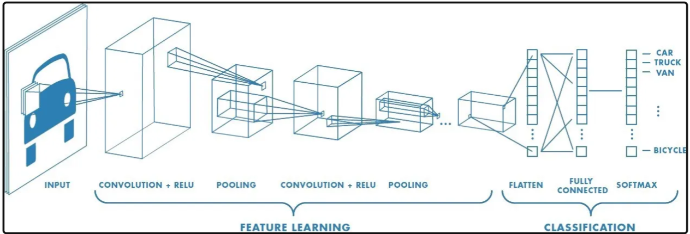
Problème : identifier et localiser des éléments spécifiques dans un flux vidéo ou des images industrielles.
Architecture :
Le modèle apprend à reconnaître des formes de plus en plus complexes, des contours aux objets entiers.
Nous partons d’un modèle déjà entraîné sur des millions d’images ordinaires, puis nous le spécialisons sur les vôtres.
Il indique à la fois où se trouve chaque élément et de quoi il s’agit.
Les deux objectifs, situer et identifier, sont appris ensemble.
Entraînement : sur vos images, avec des variantes automatiques (rotations, recadrages, variations de lumière) pour que le modèle résiste aux conditions réelles.
C’est ce qui rend le projet faisable : vous n’avez pas besoin d’un million de photos annotées, mais de quelques centaines de cas représentatifs, y compris les cas difficiles. Ceux-là valent tous les autres.
Nous validons toujours sur des images que le modèle n’a jamais vues, et nous vous montrons ses erreurs, pas seulement ses réussites.
Modèle prédictif sur données métier
Problème : anticiper un événement métier
(défaillance, churn, anomalie) à partir de données historiques hétérogènes.
Méthodologie :
- L’essentiel du travail n’est pas le modèle, c’est la donnée : ce qui manque, ce qui est aberrant, ce qui a changé de définition en cours de route.
Nous construisons les indicateurs qui portent le signal : évolutions sur plusieurs périodes, moyennes, écarts.
- Nous comparons plusieurs familles de modèles sur vos données plutôt que d’imposer la nôtre.
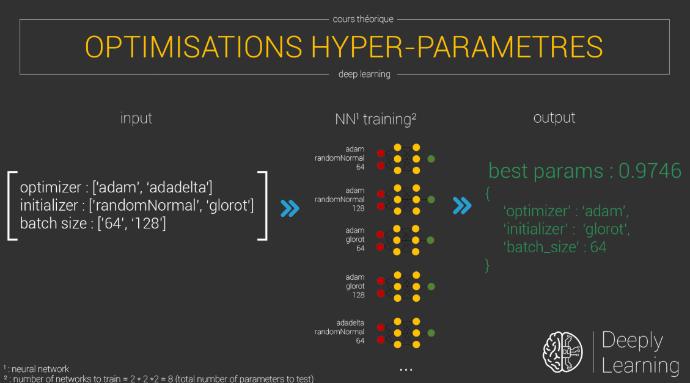
Les réglages du modèle sont cherchés automatiquement plutôt qu’à la main.
- Chaque prévision est livrée avec les facteurs qui ont pesé dans la décision : une alerte qu’on ne peut pas justifier ne sert à personne.
Nous gardons le modèle qui tient sur des données qu’il n’a jamais vues, ce qui est le seul test qui compte, et nous disons quand la donnée disponible ne permet pas de répondre à la question posée.
Des outils open source, éprouvés, documentés et maintenables
Pas de frameworks propriétaires opaques. Chaque brique est auditée, comprise et maîtrisée.
Vision & Image
OpenCV · Pillow · scikit-image · Tesseract 5 · PyTorch · torchvision · ONNX Runtime
Audio & NLP
Vosk · Sherpa-onnx · WebRTC VAD · NLTK · spaCy · HuggingFace Transformers · Kaldi
ML & Data
scikit-learn · XGBoost · LightGBM · Optuna · SHAP · Pandas · NumPy · Matplotlib
De la problématique au modèle en production : sans détour
Cadrage scientifique
On commence par comprendre le problème réel, pas la solution imaginée. Nous écrivons noir sur blanc ce que le système devra faire, sur quelles entrées, et comment nous saurons qu’il y arrive. Sans cet accord écrit, un projet se juge à l’impression, et l’impression change selon la personne qui regarde.
Données & exploration
Volume, qualité, biais, trous. Nous ne promettons rien avant d’avoir regardé vos données, et il nous arrive de conclure qu’un sujet n’est pas mûr. C’est une réponse utile, et elle vous coûte moins cher qu’un projet mené jusqu’au bout pour rien.
Essais, du simple au complexe
Nous commençons toujours par la solution la plus simple qui pourrait marcher, et nous nous en servons de étalon. Si le modèle sophistiqué ne fait pas mieux, nous le disons et nous livrons le simple.
Déploiement & intégration
Le modèle est livré avec son mode d’emploi, dans un format ouvert que vous pouvez faire tourner ailleurs, et avec de quoi le réentraîner le jour où vos données changent. Vous n’êtes pas captif : c’est la même règle que pour le reste de ce que nous faisons.
Vous avez un problème difficile à résoudre correctement.
DSI & Directions techniques
Vous avez un projet IA en cours ou en réflexion et vous cherchez un regard externe rigoureux pour le cadrer, l'évaluer ou le dérisquer.
Startups deeptech
Vous avez une idée forte mais manquez de ressources en ML/vision/NLP pour passer du POC au produit.
Porteurs de projets R&D
Vous travaillez sur un sujet aux frontières de l'IA et des mathématiques et vous avez besoin d'un partenaire technique, pas d'un prestataire généraliste.
Vous avez un problème difficile. On aime ça.
Décrivez votre projet en quelques lignes : on vous répond avec une analyse technique, pas un devis commercial.